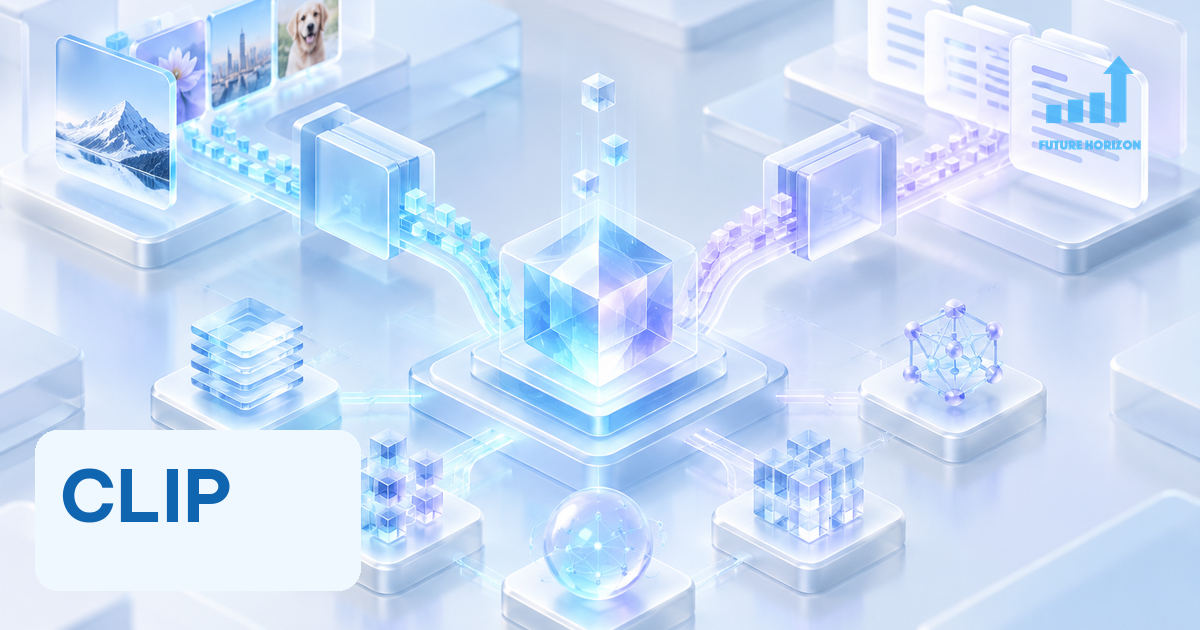
CLIP được OpenAI công bố ngày 05/01/2021, học mối liên hệ giữa hình ảnh và mô tả ngôn ngữ để nhận diện các khái niệm thị giác. Thay vì buộc người dùng huấn luyện lại một bộ phân loại cho từng bộ nhãn, CLIP có thể so ảnh với những mô tả do người dùng cung cấp. Đây là mô hình biểu diễn và đối sánh, không phải công cụ sinh ảnh như DALL·E. Công bố chính thức trình bày cả kết quả lẫn những giới hạn quan trọng.
CLIP kết nối ảnh và văn bản như thế nào?
Tên CLIP viết tắt của Contrastive Language–Image Pre-training. Mô hình huấn luyện một bộ mã hóa ảnh và một bộ mã hóa văn bản để xác định những cặp ảnh–chữ phù hợp. Tín hiệu học đến từ các cặp ảnh và văn bản trên Internet, thay vì chỉ từ một tập nhãn cố định do con người xây dựng cho một nhiệm vụ riêng.
Trong bài toán phân loại chó và mèo, có thể biến nhãn thành những câu như “a photo of a dog” và “a photo of a cat”, rồi chọn mô tả phù hợp hơn với ảnh. Zero-shot ở đây có nghĩa không cần thêm ví dụ huấn luyện cho chính nhiệm vụ đánh giá đó; không có nghĩa mô hình chưa từng tiếp xúc với dữ liệu hay khái niệm liên quan trong tiền huấn luyện.
Năng lực: chuyển giao sang nhiều nhiệm vụ thị giác
OpenAI đánh giá khả năng zero-shot trên hơn 30 bộ dữ liệu, gồm phân loại đối tượng chi tiết, định vị địa lý, nhận diện hành động trong video và OCR. Theo công bố, CLIP đạt mức tương đương ResNet-50 gốc trên ImageNet mà không dùng 1,28 triệu ví dụ gán nhãn của ImageNet để huấn luyện trực tiếp cho phép đánh giá đó.
Kết quả này không đồng nghĩa mọi nhiệm vụ đều đạt cùng chất lượng. OpenAI phân biệt phân loại zero-shot với linear probe, trong đó một bộ phân loại tuyến tính được huấn luyện trên biểu diễn đã học. Mô hình CLIP tốt nhất vượt mô hình ImageNet công khai được đem so sánh trên 20 trong 26 bộ dữ liệu chuyển giao theo thiết lập linear probe. Hai loại đánh giá không nên được trộn thành một tuyên bố chung.
Chi phí: tiết kiệm tương đối, không phải miễn phí tính toán
Trong các thí nghiệm quy mô nhỏ đến trung bình, mục tiêu tương phản hiệu quả tính toán hơn 4–10 lần so với hướng học ảnh–chú thích được nhóm nghiên cứu thử, xét theo phân loại ImageNet zero-shot. Việc dùng Vision Transformer còn cải thiện hiệu quả tính toán thêm khoảng ba lần so với ResNet tiêu chuẩn trong so sánh được công bố. Đây là kết quả trong thiết lập cụ thể, không phải cam kết tiết kiệm tương tự cho mọi hệ thống.
OpenAI cho biết mô hình CLIP tốt nhất của nghiên cứu được huấn luyện trên 256 GPU trong hai tuần. Bài công bố không đưa ra giá API cho mỗi ảnh hoặc tổng chi phí bằng tiền. Không thể lấy số GPU và thời gian rồi suy ra một mức chi phí chính xác khi chưa biết loại phần cứng, giá thuê và các khoản vận hành khác. Việc giảm nhu cầu gán nhãn riêng cho từng tác vụ cũng không loại bỏ chi phí đánh giá và kiểm soát dữ liệu.
Giới hạn: đếm, suy luận không gian và thiên lệch
CLIP nhận diện nhiều vật thể thông thường khá tốt nhưng gặp khó với tác vụ trừu tượng hoặc có tính hệ thống, chẳng hạn đếm số vật thể và dự đoán khoảng cách tới chiếc xe gần nhất. Trên hai bộ dữ liệu mà OpenAI dùng cho các ví dụ này, CLIP zero-shot chỉ nhỉnh hơn đoán ngẫu nhiên. Vì vậy, độ tương đồng ảnh–văn bản không thay thế phép đo hình học hoặc một hệ thống đếm đã được kiểm định.
Dữ liệu Internet còn mang theo thiên lệch. Công bố cũng thảo luận rủi ro quyền riêng tư và giám sát khi các biểu diễn linh hoạt được dùng cho nhận diện người. Với ứng dụng thực tế, cần đo chất lượng trên dữ liệu đúng miền, kiểm tra ảnh hưởng của cách viết nhãn và đánh giá sai lệch giữa các nhóm liên quan trước triển khai.
CLIP khác DALL·E ở đâu?
DALL·E đời đầu tạo ảnh từ văn bản; CLIP đánh giá sự phù hợp giữa ảnh và mô tả. Trong bản trình diễn DALL·E, CLIP được dùng để xếp hạng các mẫu ảnh. Hai mô hình bổ trợ cho nhau, nhưng khả năng lựa chọn một ảnh phù hợp không có nghĩa CLIP tự tạo được ảnh.
CLIP cũng tiếp nối hướng chuyển giao zero-shot được thảo luận ở GPT-3, song dữ liệu đầu vào, mục tiêu học và cách đánh giá khác nhau. Giá trị thực tế nằm ở biểu diễn đa phương thức linh hoạt; giới hạn nằm ở việc đối sánh thống kê vẫn có thể sai khi nhiệm vụ cần đếm, quan hệ không gian hoặc quyết định nhạy cảm.
Nguồn chính thức
OpenAI — CLIP: Connecting text and images, 05/01/2021. Các thông số và kết quả trong bài được trình bày theo công bố nghiên cứu, không phải một phép kiểm thử độc lập mới.

Tác giả
Chăm Sóc Khách Hàng